การเปลี่ยนผ่านการออกแบบศูนย์ข้อมูลสู่ยุค AI: จากกำลังไฟเฉลี่ยต่อแร็คสู่การออกแบบโครงสร้างพื้นฐานร่วมกับระบบประมวลผล
การเปลี่ยนผ่านการออกแบบศูนย์ข้อมูลสู่ยุค AI: จากกำลังไฟเฉลี่ยต่อแร็คสู่การออกแบบโครงสร้างพื้นฐานร่วมกับระบบประมวลผล โดย รองศาสตราจารย์ ดร.มนตรี วิบูลยรัตน์ รองคณบดี วิทยาลัยการจัดการนวัตกรรมและอุตสาหกรรม สถาบันเทคโนโลยีพระจอมเกล้าเจ้าคุณทหารลาดกระบัง (สจล.)
การเติบโตของปัญญาประดิษฐ์กำลังเปลี่ยนหลักคิดในการออกแบบศูนย์ข้อมูลอย่างมีนัยสำคัญ ทั้งโครงสร้างอาคาร การขนส่งอุปกรณ์ ระบบระบายความร้อน ระบบจ่ายไฟ และเครือข่ายสื่อสาร การรองรับ GPU รุ่นใหม่จึงไม่ได้หมายถึงการเพิ่มกำลังไฟและเครื่องปรับอากาศเท่านั้น แต่ต้องออกแบบระบบทั้งหมดให้สัมพันธ์กับลักษณะของอุปกรณ์และภาระงาน AI ตั้งแต่ระดับชิป แร็ค คลัสเตอร์ จนถึงระบบไฟฟ้าของอาคาร บทความนี้ปรับข้อมูลบางส่วนจากข้อความตั้งต้นให้ตรงกับเอกสารผู้ผลิต โดยแยกข้อกำหนดของผลิตภัณฑ์ปัจจุบันออกจากแผนเทคโนโลยีในอนาคต โดยเฉพาะระบบ 800 VDC และ Co-Packaged Optics ซึ่งยังอยู่ระหว่างการเปลี่ยนผ่านและพัฒนา
จากการออกแบบด้วยค่าเฉลี่ยสู่การออกแบบตามภาระงาน
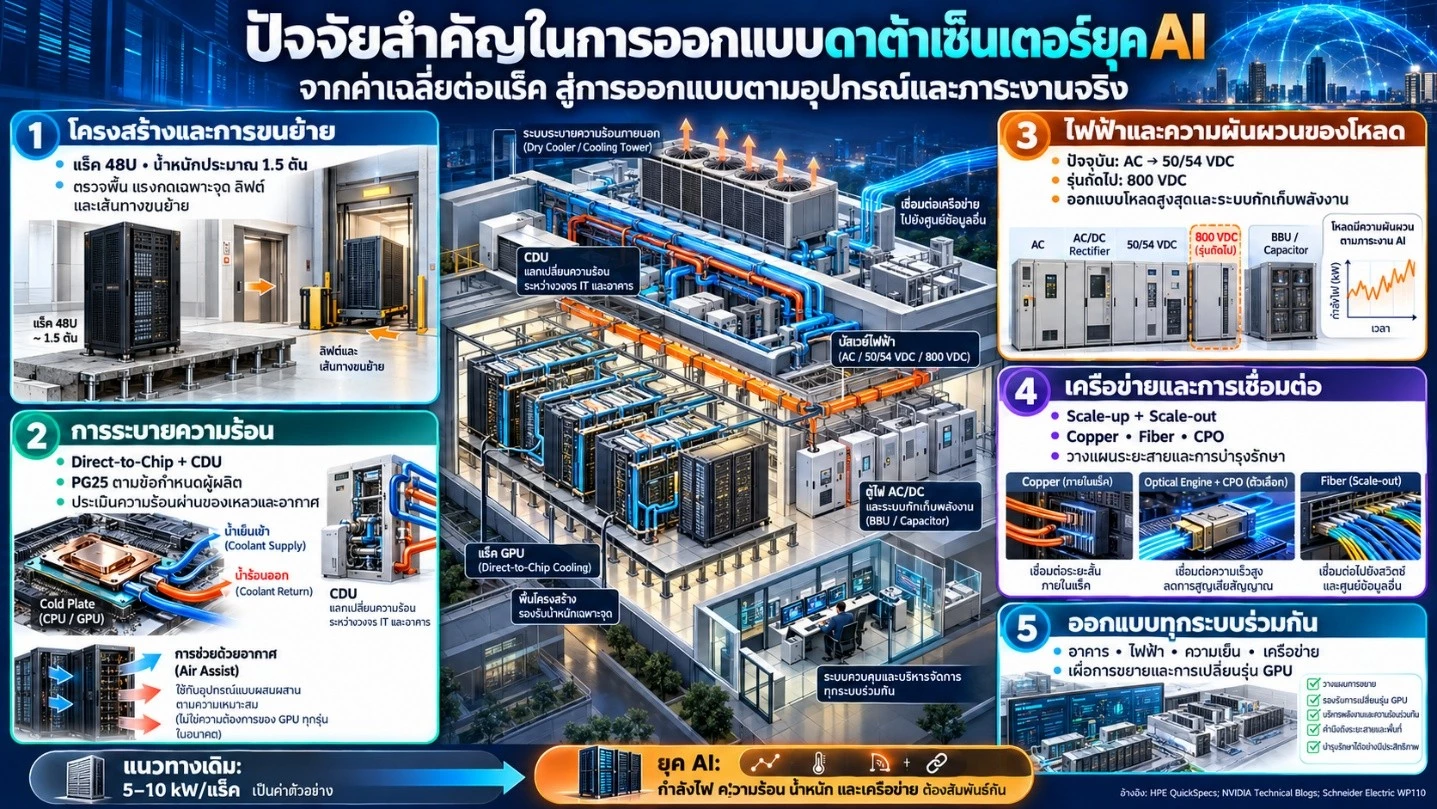
ในช่วง ค.ศ. 2000–2025 ศูนย์ข้อมูลทั่วไปจำนวนมากใช้แร็คขนาด 42U และกำหนดกำลังไฟออกแบบต่อแร็ค เช่น 5 หรือ 10 กิโลวัตต์ เพื่อประมาณความต้องการของระบบไฟฟ้าและระบบทำความเย็น วิธีนี้ช่วยให้วางแผนพื้นที่และขยายระบบเป็นหน่วยมาตรฐานได้สะดวก อย่างไรก็ตาม ตัวเลขดังกล่าวควรใช้เป็นตัวอย่างของแนวทางออกแบบ ไม่ใช่ข้อสรุปว่าศูนย์ข้อมูลทั้งหมดในช่วงเวลานั้นมีความหนาแน่นเท่ากัน เพราะระบบ HPC และศูนย์ข้อมูลความหนาแน่นสูงมีอยู่ก่อนการขยายตัวของ Generative AI แล้ว ข้อจำกัดของการใช้ค่าเฉลี่ยปรากฏชัดเมื่อแร็คประมวลผล AI ต้องการกำลังไฟสูงกว่าแร็คเครือข่ายหรือแร็คจัดเก็บข้อมูลหลายเท่า ค่าเฉลี่ยระดับห้องอาจแสดงว่ามีกำลังไฟและความเย็นเพียงพอ แต่บางตำแหน่งกลับไม่สามารถรองรับโหลดจริงได้ Schneider Electric (2026) จึงเสนอให้พิจารณาความหนาแน่นและลักษณะภาระงาน AI ร่วมกับการออกแบบระบบไฟฟ้า ระบบทำความเย็น และระบบแร็คอย่างเป็นองค์รวม ผลเชิงวิศวกรรมคือ การออกแบบควรเริ่มจากรายการอุปกรณ์จริงและรูปแบบการใช้งาน แล้วกำหนดกำลังไฟ ความร้อน น้ำหนัก และการเชื่อมต่อของแต่ละแร็คหรือแต่ละกลุ่มแร็ค แทนการกระจายทรัพยากรให้เท่ากันทั้งหมด


1. โครงสร้างอาคารและระบบขนส่งต้องรองรับแร็คที่ใหญ่และหนักขึ้น
ตัวอย่างที่สะท้อนการเปลี่ยนแปลงนี้คือ NVIDIA GB300 NVL72 by HPE ซึ่งเป็นระบบประมวลผลระดับแร็คขนาด 48U เอกสาร QuickSpecs ระบุน้ำหนักเมื่อบรรจุอุปกรณ์และของเหลวครบประมาณ 3,300 ปอนด์ หรือ 1,497 กิโลกรัม จึงควรปรับตัวเลขประมาณ 1,400 กิโลกรัมในข้อความตั้งต้นเป็นประมาณ 1.5 ตันสำหรับผลิตภัณฑ์รุ่นนี้ ทั้งนี้ น้ำหนักจริงต้องยืนยันตามการจัดอุปกรณ์ที่สั่งซื้อ (Hewlett Packard Enterprise [HPE], 2026) การนำแร็คหนัก 1,497 กิโลกรัมไปเปรียบเทียบกับพื้นรับน้ำหนัก 1,200 กิโลกรัมต่อตารางเมตรโดยตรงยังไม่เพียงพอ เพราะตัวเลขแรกเป็นมวลรวม ขณะที่ตัวเลขหลังเป็นน้ำหนักกระจายต่อพื้นที่ และ 1,200 กิโลกรัมต่อตารางเมตรไม่ควรถูกอ้างเป็นมาตรฐานสากลที่ใช้กับศูนย์ข้อมูลทุกแห่ง
เพื่อแสดงหลักการ สมมติแร็คหนัก 1,500 กิโลกรัมมีพื้นที่ฐาน 0.72 ตารางเมตร น้ำหนักเฉลี่ยบนพื้นที่ฐานจะเท่ากับ
1,500/0.72 = 2,083 กิโลกรัมต่อตารางเมตร
ตัวอย่างนี้เป็นการคำนวณประกอบคำอธิบาย ไม่ใช่ค่ารับรองความปลอดภัยของพื้น เพราะแรงจริงอาจกระจุกตัวที่ขาปรับระดับหรือล้อ และถ่ายลงแผ่นพื้น คาน หรือเสาแตกต่างกันตามโครงสร้าง ดังนั้น การตรวจสอบต้องครอบคลุมทั้งพื้นโครงสร้าง พื้นยก แรงกดเฉพาะจุด และเส้นทางขนย้าย ได้แก่ จุดรับสินค้า ทางลาด ประตู ทางเลี้ยว ลิฟต์ขนของ และพื้นที่ติดตั้ง โดยรวมมวลของอุปกรณ์ขนย้ายและผลจากการเคลื่อนที่ด้วย ข้อเสนอเชิงวิศวกรรมคือให้ประเมินความสามารถรองรับแร็คตลอดเส้นทางตั้งแต่รับสินค้าเข้าสู่อาคารจนถึงตำแหน่งใช้งาน ไม่จำกัดเฉพาะพื้นห้องคอมพิวเตอร์
2. ระบบทำความเย็นเปลี่ยนจากการจัดการอากาศสู่การดึงความร้อนที่แหล่งกำเนิด
เมื่อ CPU และ GPU มีความหนาแน่นทางความร้อนสูงขึ้น การเพิ่มปริมาณลมเพียงอย่างเดียวอาจไม่สามารถรองรับอุปกรณ์ได้อย่างเหมาะสม ระบบ Direct-to-Chip หรือ D2C จึงใช้แผ่นระบายความร้อนที่สัมผัสกับอุปกรณ์โดยตรง และส่งความร้อนออกผ่านของเหลวหมุนเวียน PG25 เป็นตัวอย่างของสารหล่อเย็นที่ใช้ในระบบบางรุ่น โดยประกอบด้วยโพรพิลีนไกลคอลประมาณ 25% และน้ำประมาณ 75% อย่างไรก็ตาม PG25 (propylene glycol 25%) เป็นชนิดของสารหล่อเย็น ส่วน D2C เป็นวิธีระบายความร้อน จึงไม่ใช่คำที่ใช้แทนกัน และการเลือกสารหล่อเย็นต้องเป็นไปตามข้อกำหนดของผู้ผลิต (Parker, 2026) องค์ประกอบสำคัญคือ Coolant Distribution Unit: CDU ซึ่งเชื่อมระบบของเหลวฝั่งอุปกรณ์ไอทีกับระบบระบายความร้อนของอาคาร ในระบบแบบ liquid-to-liquid CDU จะถ่ายเทความร้อนผ่านเครื่องแลกเปลี่ยนความร้อน พร้อมควบคุมการหมุนเวียนและสภาวะของสารหล่อเย็น การออกแบบจึงต้องพิจารณากำลังระบายความร้อน อัตราการไหล ความดันตกคร่อม อุณหภูมิ คุณภาพของเหลว ความเข้ากันได้ของวัสดุ และระบบตรวจจับการรั่วร่วมกัน ข้อเสนอเชิงวิศวกรรมคือ ต้องออกแบบความพร้อมใช้งานของปั๊ม CDU และระบบควบคุมให้สอดคล้องกับระบบไฟฟ้าสำรอง เพราะการมีไฟเลี้ยง GPU ต่อเนื่องจะไม่มีประโยชน์หากระบบหมุนเวียนสารหล่อเย็นหยุดทำงาน สำหรับระบบแบบผสม ยังต้องจัดการความร้อนส่วนที่ไม่ได้ถ่ายออกผ่านของเหลว เช่น หน่วยความจำ อุปกรณ์จัดเก็บข้อมูล วงจรจ่ายไฟ และอุปกรณ์เครือข่าย แต่ไม่ควรสรุปว่า AI เซิร์ฟเวอร์ทุกรุ่นจะต้องใช้ระบบอากาศเสมอไป เนื่องจาก NVIDIA ระบุว่าโครงสร้างพื้นฐาน Rubin รุ่นใหม่ออกแบบให้ใช้การระบายความร้อนด้วยของเหลวทั้งหมดและมี compute tray แบบไม่มีพัดลม ขณะที่อุปกรณ์อื่นของอาคารยังต้องประเมินตามข้อกำหนดของตนเอง (Bhargava et al., 2026; Parker, 2026)
3. ระบบไฟฟ้าต้องรองรับทั้งความหนาแน่นสูงและการเปลี่ยนโหลดอย่างรวดเร็ว
การเปลี่ยนผ่านระบบไฟฟ้าของ AI Data Center ต้องแยกให้ชัดระหว่างผลิตภัณฑ์ปัจจุบันกับสถาปัตยกรรมรุ่นถัดไป ตัวอย่างเช่น GB300 NVL72 by HPE ยังรับไฟ AC เข้าสู่ power shelf ก่อนแปลงเป็น 50 VDC และกระจายไฟผ่าน busbar ภายในแร็ค จึงไม่ควรระบุว่า NVL72 ทุกรุ่นใช้ไฟเข้า 800 VDC แล้ว (HPE, 2026) NVIDIA เสนอสถาปัตยกรรม 800 VDC เพื่อรองรับแร็คระดับเมกะวัตต์ โดยลดขั้นตอนการแปลงพลังงานและกระจายไฟด้วยแรงดันสูงขึ้น ก่อนลดแรงดันใกล้อุปกรณ์ประมวลผล พันธมิตรที่ร่วมพัฒนาครอบคลุม Delta, Schneider Electric, Vertiv, Infineon และ STMicroelectronics เป็นต้น (Blake et al., 2025) หลักการพื้นฐานแสดงได้จาก (I=P/V) หากโหลด DC มีขนาด 1 เมกะวัตต์ กระแสในระบบ 54 V จะประมาณ 18,519 แอมแปร์ ขณะที่ระบบ 800 V จะประมาณ 1,250 แอมแปร์ ตัวเลขนี้เป็นการเปรียบเทียบอุดมคติโดยไม่รวมการสูญเสีย แต่แสดงเหตุผลที่แรงดันสูงช่วยลดภาระของตัวนำและการจัดการกระแสภายในระบบได้
อย่างไรก็ตาม การเปลี่ยนผ่านไม่ได้มีเพียงรูปแบบเดียว Petty (2026) อธิบายทั้งแนวทาง power rack ที่รับไฟจากโครงสร้าง AC เดิมแล้วจ่าย 800 VDC แนวทางศูนย์จ่ายไฟระดับแถว และแนวทางอาคารใหม่ที่แปลงไฟแรงดันปานกลางเป็น DC ส่วนกลาง ผู้ประกอบการจึงสามารถเลือกรูปแบบตามสภาพอาคารและอุปกรณ์ที่จะติดตั้งได้ ตัวเลขประสิทธิภาพ 98.5% ต้องระบุขอบเขตให้ถูกต้อง เอกสาร Delta ระบุค่านี้สำหรับ Solid-State Transformer ที่แปลงไฟ AC แรงดันปานกลางเป็น 800 VDC ไม่ใช่ประสิทธิภาพรวมตั้งแต่โครงข่ายไฟฟ้าถึงแกน GPU และไม่ใช่ค่าของ DC/DC power shelf ทุกผลิตภัณฑ์ (Delta Electronics, 2025) นอกจากกำลังไฟสูงแล้ว การฝึกโมเดลขนาดใหญ่ยังทำให้ GPU จำนวนมากเปลี่ยนโหลดพร้อมกันระหว่างช่วงคำนวณและช่วงแลกเปลี่ยนข้อมูล ระบบจึงต้องรองรับความผันผวนของกำลังไฟด้วย NVIDIA เสนอการกักเก็บพลังงานหลายช่วงเวลา โดยใช้ตัวเก็บประจุสำหรับการตอบสนองรวดเร็วร่วมกับแบตเตอรี่สำหรับช่วงเวลาที่ยาวกว่า ตำแหน่งติดตั้งและขนาดต้องสัมพันธ์กับสถาปัตยกรรมจริง ไม่จำเป็นต้องอยู่ใน power shelf ของทุกแร็คเสมอไป (Srivastava & Petty, 2025) ข้อเสนอเชิงวิศวกรรมคือ การออกแบบต้องใช้ทั้งกำลังไฟเฉลี่ย กำลังไฟสูงสุด อัตราการเปลี่ยนโหลด และพฤติกรรมหลังไฟฟ้าขัดข้อง พร้อมตรวจสอบการป้องกันวงจร DC การแยกวงจร และความปลอดภัยในการบำรุงรักษา
4. CPO เปลี่ยนการออกแบบเครือข่าย แต่ต้องแยก Scale-up และ Scale-out
Co-Packaged Optics หรือ CPO คือการนำ optical engine มารวมอยู่ในแพ็กเกจเดียวกันหรือใกล้กับชิปประมวลผลสัญญาณ เช่น switch ASIC เพื่อลดระยะทางของสัญญาณไฟฟ้าความเร็วสูงก่อนแปลงเป็นแสง วิธีนี้ช่วยลดข้อจำกัดด้านการสูญเสียสัญญาณและพลังงานเมื่อเทียบกับการส่งสัญญาณผ่านลายวงจรไปยัง optical transceiver ที่อยู่ห่างออกไป ทั้งนี้ ไม่ได้หมายความว่าองค์ประกอบทั้งหมด รวมถึงแหล่งกำเนิดเลเซอร์ ต้องอยู่บนชิปเดียวกันเสมอ (NVIDIA, 2025) การอธิบายผลต่อ AI Data Center ต้องแยกเครือข่ายสองระดับ ได้แก่ Scale-up สำหรับเชื่อม GPU ภายในโดเมนประมวลผลเดียวกัน และ Scale-out สำหรับเชื่อมระบบประมวลผลหลายกลุ่มผ่านเครือข่าย เช่น Ethernet หรือ InfiniBand การใช้ CPO ในสวิตช์ Scale-out จึงไม่ได้แปลว่า GPU ทุกตัวมี CPO อยู่บนแพ็กเกจแล้ว NVIDIA ประกาศ Spectrum-X Photonics และ Quantum-X Photonics เพื่อรองรับเครือข่าย AI พร้อมระบุว่าเทคโนโลยีดังกล่าวจะทำงานร่วมกับ optical transceiver แบบเสียบถอดได้ด้วย (NVIDIA, 2025)
สำหรับแผนพัฒนารุ่นถัดไป เอกสาร NVIDIA เดือนมีนาคม 2026 อธิบายว่า Vera Rubin Ultra NVL576 จะเชื่อมแร็ค NVL72 จำนวนแปดแร็คด้วยการเชื่อมต่อทองแดงและแสง ส่วน Kyber เริ่มจากระบบ NVL144 และเป็นฐานสำหรับขยายสู่ NVL1152 ในยุค Feynman (Bhargava et al., 2026) อย่างไรก็ตาม เอกสารที่ตรวจสอบยังไม่เพียงพอสำหรับยืนยันข้อความว่า Feynman จะติดตั้ง CPO โดยตรงบน GPU ทุกตัว หรือยืนยันรายละเอียด “1.6T–3.2T และ OCI” เป็นข้อกำหนดผลิตภัณฑ์ที่แน่นอน จึงควรเขียนว่าเป็นทิศทางพัฒนา optical scale-up และ CPO พร้อมอ้างอิงเอกสารผลิตภัณฑ์รุ่นล่าสุดเมื่อใช้กำหนดแบบก่อสร้างหรือจัดซื้อ ผลเชิงวิศวกรรมคือ ต้องวางแผนเครือข่ายร่วมกับตำแหน่งแร็ค ระยะสาย เส้นทางใยแก้วนำแสง พื้นที่สวิตช์ ความสะอาดของหัวต่อ และวิธีซ่อมบำรุง โดยพิจารณาว่าชิ้นส่วนใดสามารถเปลี่ยนแยกได้และชิ้นส่วนใดรวมอยู่ในชุดอุปกรณ์เดียวกัน
นัยต่อการออกแบบและลงทุนในประเทศไทย
จากหลักฐานข้างต้น ผู้เขียนเสนอว่า AI Data Center ควรใช้กระบวนการออกแบบร่วมกันระหว่างทีมอาคาร โครงสร้าง ไฟฟ้า เครื่องกล เครือข่าย และผู้ผลิตระบบประมวลผล โดยกำหนดข้อมูลขั้นต่ำของแต่ละแร็คให้ครบก่อนตัดสินใจลงทุน ได้แก่ น้ำหนักและแรงกดเฉพาะจุด กำลังไฟเฉลี่ยและสูงสุด ความผันผวนของโหลด สัดส่วนความร้อนที่ระบายด้วยของเหลว อัตราการไหล และโครงสร้างเครือข่าย สำหรับอาคารเดิม ควรประเมินเส้นทางขนย้าย ความสามารถของพื้น กำลังไฟที่เหลือ และความพร้อมของระบบของเหลวก่อนเลือกอุปกรณ์ ส่วนอาคารใหม่ควรเผื่อการเปลี่ยนรุ่นของ GPU ด้วยพื้นที่และจุดเชื่อมต่อที่ขยายได้ โดยไม่จำเป็นต้องติดตั้งกำลังสำรองสูงสุดทั้งหมดตั้งแต่วันแรก ในประเทศไทย การใช้ของเหลวอุณหภูมิสูงเปิดโอกาสให้ลดภาระระบบทำความเย็น แต่ความสามารถใช้ dry cooler ต้องคำนวณจากอากาศภายนอก อุณหภูมิของเหลวที่อุปกรณ์ยอมรับ และส่วนต่างอุณหภูมิของเครื่องแลกเปลี่ยนความร้อน จึงไม่ควรนำข้อกล่าวอ้างเรื่องการใช้งานโดยไม่มี chiller ในภูมิอากาศเย็นมาใช้กับประเทศไทยโดยตรง Parker (2026) ระบุชัดว่าประโยชน์ของแนวทางดังกล่าวขึ้นอยู่กับภูมิศาสตร์และสภาพภูมิอากาศ การเปลี่ยนผ่านครั้งนี้ทำให้หน่วยออกแบบสำคัญขยายจาก “แร็คมาตรฐาน” ไปสู่ “ระบบประมวลผลที่ทำงานร่วมกัน” ความสำเร็จจึงขึ้นอยู่กับการทำให้กำลังประมวลผล โครงสร้างอาคาร พลังงาน ความร้อน และเครือข่ายสอดคล้องกันตลอดอายุโครงการ
เอกสารอ้างอิง
- Bhargava, R., Allison, T., & Petty, H. (2026, March 16). NVIDIA Vera Rubin POD: Seven chips, five rack-scale systems, one AI supercomputer. NVIDIA Technical Blog. https://developer.nvidia.com/blog/?p=113993
- Blake, M., Hsu, M., Goldwasser, I., Petty, H., & Huntington, J. (2025, May 20). NVIDIA 800 VDC architecture will power the next generation of AI factories. NVIDIA Technical Blog. https://developer.nvidia.com/blog/nvidia-800-v-hvdc-architecture-will-power-the-next-generation-of-ai-factories/
- Delta Electronics. (2025). Delta to demonstrate seamlessly integrated high voltage DC power, advanced cooling, and networking solutions to drive AI data center evolution at OCP Global Summit 2025. https://www.delta-americas.com/en-US/news/39902
- Hewlett Packard Enterprise. (n.d.). NVIDIA GB300 NVL72 by HPE QuickSpecs. Retrieved October 7, 2026, from https://www.hpe.com/us/en/collaterals/collateral.a50009244enw.html
- NVIDIA. (2025, March 18). NVIDIA announces Spectrum-X Photonics, co-packaged optics networking switches to scale AI factories to millions of GPUs. https://nvidianews.nvidia.com/news/nvidia-spectrum-x-co-packaged-optics-networking-switches-ai-factories
- NVIDIA. (2025, August 26). How industry collaboration fosters NVIDIA co-packaged optics. NVIDIA Technical Blog. https://developer.nvidia.com/blog/how-industry-collaboration-fosters-nvidia-co-packaged-optics/
- Parker, J. (2026, June 21). Hotter than a hot tub: The 45°C breakthrough to cool AI’s biggest machines. NVIDIA Blog. https://blogs.nvidia.com/blog/liquid-cooling-ai-factories/
- Petty, H. (2026, August 11). Why scaling AI compute performance requires a new power architecture. NVIDIA Blog. https://blogs.nvidia.com/blog/800-vdc-power-architecture-ai-factory/
- Schneider Electric. (2026, May 21). How 6 AI attributes change data center design (Version 3.1, White Paper 110). https://www.se.com/us/en/download/document/SPD_WP110_EN/
- Srivastava, N., & Petty, H. (2025, October 13). Building the 800 VDC ecosystem for efficient, scalable AI factories. NVIDIA Technical Blog. https://developer.nvidia.com/blog/building-the-800-vdc-ecosystem-for-efficient-scalable-ai-factories/
