Tier III คืออะไร? ทำไม Data Center ระดับองค์กรถึงเลือกมาตรฐาน Concurrently Maintainable
Tier III คืออะไร? ทำไม Data Center ระดับองค์กรถึงเลือกมาตรฐาน Concurrently Maintainable โดย อาจารย์ ดร.เมทังกร เสริมสุข (CIIM – KMITL) วิทยาลัยการจัดการนวัตกรรมและอุตสาหกรรม สถาบันเทคโนโลยีพระจอมเกล้าเจ้าคุณทหารลาดกระบัง (สจล.)
เมื่อ Data Center กำลังกลายเป็นโครงสร้างพื้นฐานสำคัญของเศรษฐกิจดิจิทัล ตั้งแต่ Cloud, Banking, Telecom, Healthcare ไปจนถึง Artificial Intelligence คำถามสำคัญจึงไม่ได้มีเพียงว่า Data Center แห่งหนึ่งมีขนาดกี่ MW ใช้ GPU กี่ตัว หรือมี PUE ต่ำเพียงใด แต่ยังมีอีกคำถามที่สำคัญไม่แพ้กันคือ “ถ้าต้องปิดอุปกรณ์บางส่วนเพื่อซ่อมบำรุง Data Center จะยังทำงานต่อได้หรือไม่?”
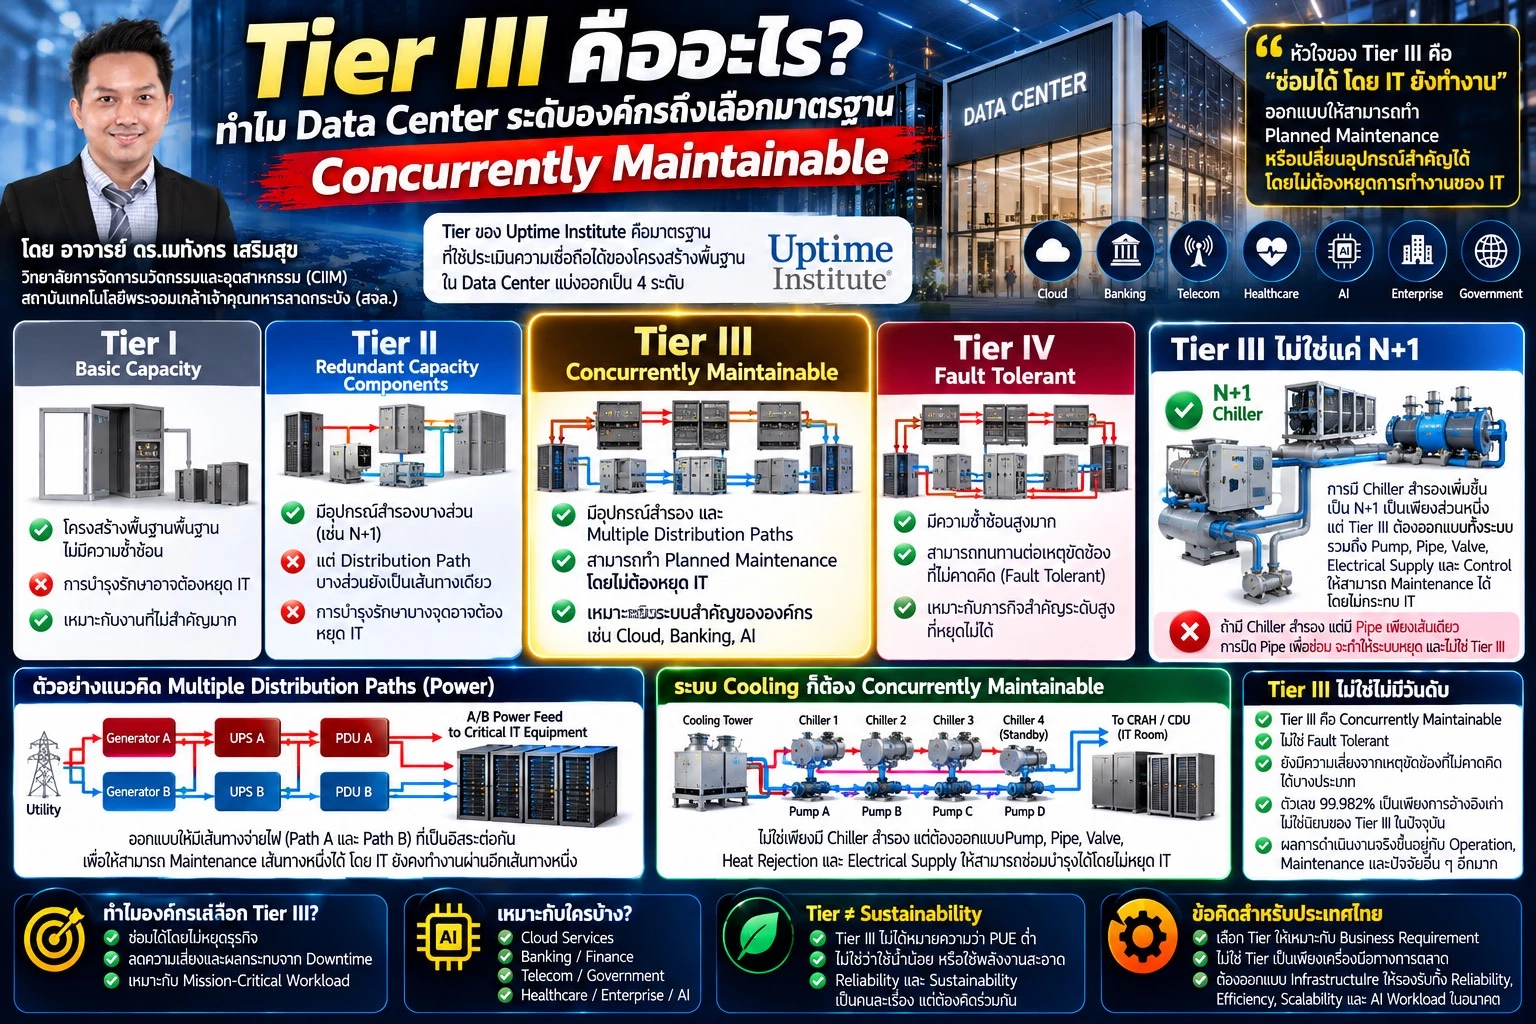
นี่คือจุดที่มาตรฐาน Tier ของ Uptime Institute เข้ามามีบทบาท Uptime Institute แบ่ง Data Center Infrastructure ออกเป็น 4 ระดับ ได้แก่ Tier I - Basic Capacity, Tier II - Redundant Capacity Components, Tier III - Concurrently Maintainable และ Tier IV - Fault Tolerant
ในบรรดาระดับเหล่านี้ Tier III เป็นระดับที่น่าสนใจอย่างมากสำหรับ Data Center ที่รองรับระบบสำคัญขององค์กร เพราะหัวใจของมันไม่ได้หมายความเพียงว่า “มีอุปกรณ์สำรอง” แต่หมายถึงการออกแบบ Infrastructure ให้สามารถทำ Planned Maintenance หรือเปลี่ยนอุปกรณ์สำคัญได้โดยไม่จำเป็นต้องหยุดการทำงานของ IT
คำสำคัญที่สุดจึงมีเพียงสองคำคือ Concurrently Maintainable
หัวใจของ Tier III คือ “ซ่อมได้โดย IT ยังทำงาน”
ลองจินตนาการถึง Data Center ที่เปิดให้บริการตลอด 24 ชั่วโมง 365 วัน UPS ต้องตรวจสอบ Generator ต้องบำรุงรักษา Chiller ต้อง Overhaul Pump ต้องเปลี่ยน Switchgear ต้องตรวจ Valve ต้องซ่อม Cable หรือ Distribution Path บางส่วนอาจต้องถูกแยกออกจากระบบ
คำถามคือ ทุกครั้งที่ต้องทำ Maintenance เราจะต้องปิด Data Center หรือไม่?
สำหรับ Tier III คำตอบคือ ไม่ควรต้องปิด IT เพื่อทำ Planned Maintenance ของ Site Infrastructure
หลักการของ Uptime Institute คือ Capacity Component และ Distribution Path แต่ละส่วนต้องสามารถถูกนำออกจากระบบตามแผนเพื่อ Maintenance หรือ Replacement ได้ โดยไม่ส่งผลกระทบต่อการทำงานของ IT
นี่คือความแตกต่างที่สำคัญจาก Tier I และ Tier II
Tier II อาจมีอุปกรณ์สำรอง เช่น Generator, UPS, Chiller หรือ Pump เพิ่มขึ้นมาแล้ว แต่ Distribution Path บางส่วนยังสามารถเป็น Single Path ได้ ดังนั้นการ Maintenance บางตำแหน่งของเส้นทางจ่ายไฟหรือระบบ Mechanical ยังอาจจำเป็นต้องหยุด IT
Tier III จึงก้าวไปอีกขั้น ไม่ใช่แค่ “มีเครื่องสำรอง” แต่ต้องคิดถึง “เส้นทางสำรอง” ด้วย


Tier III ไม่ใช่แค่ N+1
หลายคนเข้าใจว่า Tier III เท่ากับ N+1 ความเข้าใจนี้ถูกเพียงบางส่วน
สมมติระบบ Cooling ต้องใช้ Chiller 3 เครื่องเพื่อรองรับ Design Load หรือ N = 3 ถ้าเพิ่ม Chiller อีกหนึ่งเครื่องเป็น 4 เครื่อง เราอาจเรียก Capacity Configuration นี้ว่า N+1
เมื่อ Chiller เครื่องหนึ่งถูกนำออกไป Maintenance ระบบยังเหลือ 3 เครื่องสำหรับรองรับ Load แต่เพียงเท่านี้ยังไม่ได้แปลว่า Data Center ทั้งแห่งเป็น Tier III
เพราะต้องถามต่อว่า แล้ว Pump ล่ะ? Cooling Tower หรือ Heat Rejection Equipment ล่ะ? Pipe ล่ะ? Valve ล่ะ? Electrical Supply ที่จ่ายให้ Chiller ล่ะ? Control System ล่ะ?
ถ้ามี Chiller สำรองหนึ่งเครื่อง แต่มี Pipe เพียงเส้นเดียว และการปิด Pipe เส้นนั้นทำให้ Cooling ทั้งระบบหยุด Data Center ก็ยังไม่บรรลุหลัก Concurrent Maintainability
นี่คือเหตุผลที่ Tier III ต้องมอง ทั้งระบบ ไม่ใช่มองเพียงจำนวนเครื่องจักร
Multiple Distribution Paths สำคัญพอ ๆ กับอุปกรณ์สำรอง
อีกหัวใจหนึ่งของ Tier III คือการมี Multiple Independent Distribution Paths สำหรับ Infrastructure ที่รองรับ Critical Environment
ในระบบไฟฟ้า เราอาจอธิบายอย่างง่ายว่า Data Center มีเส้นทาง Path A และ Path B แทนที่จะพึ่งพาเส้นทางเดียวตั้งแต่ต้นทางจนถึง Server
แนวคิดเดียวกันต้องถูกพิจารณากับระบบ Mechanical ด้วย เพราะ Data Center ไม่ได้หยุดทำงานเฉพาะเมื่อไฟฟ้าดับ หาก Cooling หาย ระบบ IT ก็ไม่สามารถทำงานต่อไปได้อย่างปลอดภัยเช่นกัน
ดังนั้น Tier III จึงเป็นเรื่องของ Power Path + Cooling Path + Capacity ทำงานร่วมกัน ไม่ใช่เพียงการซื้อ Generator หรือ UPS เพิ่มอีกหนึ่งเครื่อง
Server ต้องคิดแบบ A/B Power Feed
สำหรับ Critical IT Equipment แนวคิด Dual Power มีความสำคัญอย่างมาก
Server ที่มี Power Supply สองชุดสามารถรับไฟจาก PSU A → PDU A และ PSU B → PDU B โดยแต่ละด้านเชื่อมโยงกับ Distribution Path ที่เหมาะสม
เมื่อจำเป็นต้องนำ Distribution Path ฝั่งหนึ่งออกจากระบบเพื่อ Planned Maintenance อีกฝั่งหนึ่งยังสามารถรักษาการทำงานของ IT Equipment ได้
สำหรับอุปกรณ์ IT ที่ไม่ได้รองรับ Dual Power โดยตรง อาจต้องมี Point-of-Use Transfer Device ที่เหมาะสมเข้ามาช่วย
ดังนั้นสิ่งที่อยู่หลัง Rack จึงมีความสำคัญไม่แพ้สิ่งที่อยู่หน้า Rack GPU จะเร็วเพียงใดก็ไม่มีประโยชน์ หาก Power Distribution Architecture ไม่สามารถรองรับการ Maintenance ได้
Generator และ UPS ต้องมองทั้ง Capacity และ Distribution
ใน Data Center ทั่วไป เรามักเห็น Generator, UPS, Battery, ATS, Switchgear และ PDU จำนวนมาก แต่การมีอุปกรณ์จำนวนมากไม่ได้ทำให้เป็น Tier III โดยอัตโนมัติ
คำถามสำคัญคือ ถ้าปิด UPS ตัวนี้เพื่อ Maintenance จะเกิดอะไรขึ้น? ถ้าแยก Switchgear ชุดนี้ออก ระบบ IT ยังมีไฟหรือไม่? ถ้าต้องเปลี่ยน Breaker จะกระทบ Critical Load หรือไม่? ถ้าต้อง Maintenance Generator หนึ่งเครื่อง Capacity ที่เหลือยังเพียงพอหรือไม่?
Tier III จึงเป็นการออกแบบให้ Capacity Component และ Distribution Path สามารถถูกนำออกจาก Service ตามแผนได้ โดย IT Operation ยังดำเนินต่อ
นี่เป็นแนวคิดที่ลึกกว่าคำว่า “มีเครื่องสำรอง”
Cooling ของ Tier III ก็ต้อง Concurrently Maintainable
สำหรับ AI Data Center ประเด็นนี้ยิ่งสำคัญ
ในอดีต Server Rack อาจมี Heat Density ไม่สูงมาก แต่ AI Infrastructure กำลังผลัก Rack Density สูงขึ้น และทำให้ Cooling กลายเป็น Critical Infrastructure อย่างเต็มรูปแบบ
ระบบอาจประกอบด้วย Chiller, Cooling Tower, Dry Cooler, CRAH, CDU, Pump, Heat Exchanger, Valve และ Pipe Network
ไม่ว่าจะใช้ Air Cooling หรือ Liquid Cooling หลักคิดยังเหมือนเดิม หาก Component หรือ Distribution Element ที่จำเป็นต้อง Maintenance ถูกนำออกจากระบบตามแผน ระบบที่เหลือต้องยังสามารถรองรับ Critical IT Environment ได้
ตัวอย่างเช่น ถ้า Design Load ต้องใช้ Chiller 3 เครื่อง การติดตั้ง 4 เครื่องอาจช่วยสร้าง N+1 Capacity แต่ต้องออกแบบ Pump, Pipe, Electrical Supply และ Heat Rejection ให้สอดคล้องกันด้วย ไม่เช่นนั้น Chiller ตัวที่ 4 อาจเป็นเพียง “เครื่องสำรองบนกระดาษ”
MCC ก็อาจกลายเป็น Single Point ที่ถูกมองข้าม
Motor Control Center หรือ MCC เป็นอีกจุดที่ต้องระวัง MCC ทำหน้าที่ควบคุมและจ่ายไฟให้ Motor ของอุปกรณ์สำคัญ เช่น Pump, Fan และอุปกรณ์ Mechanical ต่าง ๆ
ลองสมมติว่า Data Center มี Cooling Pump 4 ตัวแบบ N+1 ดูเหมือนมี Redundancy เพียงพอ แต่ Pump ทั้ง 4 ตัวรับไฟผ่าน MCC ชุดเดียว หากต้องปิด MCC เพื่อ Maintenance Pump ทั้งหมดอาจหยุดพร้อมกัน
N+1 ที่ระดับ Pump จึงไม่สามารถช่วยอะไรได้
นี่คือตัวอย่างที่อธิบายได้ดีว่า Tier III ต้องมองตั้งแต่ Source → Distribution → Equipment → Critical Load ตลอดทั้งเส้นทาง
Tier III ไม่ได้แปลว่า “ไม่มีวันดับ”
นี่เป็นอีกความเข้าใจผิดที่สำคัญ Tier III คือ Concurrently Maintainable ไม่ใช่ Fault Tolerant
Tier III ถูกออกแบบให้ Planned Maintenance สามารถเกิดขึ้นได้โดยไม่กระทบ IT แต่ไม่ได้หมายความว่าเหตุขัดข้องที่ไม่ได้วางแผนทุกชนิดจะไม่มีผลกระทบ
Uptime Institute ระบุชัดว่า Tier III ยังคงมี Exposure ต่อ Equipment Failure หรือ Operator Error บางประเภท
นี่คือเส้นแบ่งสำคัญระหว่าง Tier III กับ Tier IV
Tier IV เพิ่มแนวคิด Fault Tolerance
กล่าวอย่างง่ายคือ Tier III ถามว่า “ถ้าผมต้องปิดอุปกรณ์นี้เพื่อซ่อมตามแผน ระบบยังทำงานหรือไม่?”
ขณะที่ Tier IV เพิ่มคำถามว่า “ถ้าเกิด Failure ขึ้นโดยไม่คาดคิด ระบบยังสามารถรักษา Critical Operation ได้หรือไม่?”
สองคำถามนี้คล้ายกัน แต่ในทางวิศวกรรมแตกต่างกันมาก
แล้ว Availability 99.982% และ Downtime 1.6 ชั่วโมงต่อปีล่ะ?
หลายบทความในอดีตมักอธิบาย Tier III ด้วยตัวเลข Availability ประมาณ 99.982% และ Downtime ประมาณ 1.6 ชั่วโมงต่อปี
ตัวเลขนี้ถูกนำมาใช้อ้างอิงอย่างแพร่หลายในวงการมานาน แต่หากต้องการเข้าใจมาตรฐาน Tier III ตามแนวทางของ Uptime Institute ในปัจจุบัน ไม่ควรใช้ตัวเลขดังกล่าวเป็นนิยามของ Tier III
เพราะ Tier Classification เป็น Performance-Based Infrastructure Topology Standard
หัวใจคือความสามารถของ Architecture ไม่ใช่การรับประกันว่า Data Center จะดับไม่เกินกี่นาทีต่อปี
Data Center ที่ได้รับ Tier III Certification จึงไม่ได้หมายความว่า Uptime Institute รับประกัน SLA ว่าจะมี Availability 99.982% ทุกปี
ผลการดำเนินงานจริงยังขึ้นอยู่กับ Operation, Maintenance, Human Error, Equipment Reliability, Capacity Management และเหตุการณ์ภายนอกอีกจำนวนมาก
ดังนั้นคำที่ควรจำเกี่ยวกับ Tier III ไม่ใช่ 99.982% แต่คือ Concurrently Maintainable
ทำไม Tier III จึงน่าสนใจสำหรับธุรกิจ?
เหตุผลสำคัญคือ Data Center ในปัจจุบันไม่สามารถหลีกเลี่ยง Maintenance ได้
เครื่องจักรทุกชนิดต้องได้รับการตรวจสอบ Battery เสื่อม Bearing สึก Filter ต้องเปลี่ยน UPS ต้อง Service Generator ต้องทดสอบ Pump ต้อง Overhaul Switchgear ต้องตรวจ
ถ้า Infrastructure ถูกออกแบบแบบ Single Path ทุกครั้งที่ต้อง Maintenance จุดสำคัญ ธุรกิจอาจต้องเลือกระหว่าง “ไม่ซ่อม” กับ “ปิดระบบ”
ทั้งสองทางเลือกมีความเสี่ยง
Tier III จึงพยายามแก้โจทย์นี้ตั้งแต่ Design Stage ทำให้ Data Center สามารถ Maintenance while Operating ได้
Tier III เหมาะกับใคร?
Tier III สามารถเหมาะกับองค์กรที่มี Mission-Critical Workload และไม่สามารถหยุดบริการเพื่อ Maintenance Infrastructure ได้ง่าย เช่น Cloud Services, Banking, Telecom, Government Services, Healthcare, Enterprise Systems และ Digital Platforms
อย่างไรก็ตาม ไม่ควรตีความว่าองค์กรทุกประเภทเหล่านี้ “ต้อง” ใช้ Tier III
ระดับ Tier ที่เหมาะสมควรเกิดจาก Business Requirement + Risk + Cost + Consequence of Downtime
องค์กรบางแห่งอาจต้องการ Tier IV บางแห่งอาจเพียง Tier II ขณะที่ Hyperscale Operator บางรายอาจใช้ Proprietary Architecture ของตนเองแทนการออกแบบตาม Certification Model แบบเดียวกันทั้งหมด
ดังนั้น Tier สูงที่สุดไม่ได้หมายความว่าเหมาะสมที่สุดเสมอไป สิ่งสำคัญคือเลือก Reliability Architecture ให้ตรงกับ Business Requirement
แล้ว AI Data Center จำเป็นต้องเป็น Tier III หรือไม่?
AI กำลังทำให้คำถามนี้น่าสนใจมากขึ้น
GPU Cluster มีมูลค่าสูง และ AI Training Job บางประเภทสามารถใช้เวลานาน รวมทั้ง Infrastructure สำหรับ High-Density Computing ต้องพึ่งพาทั้ง Power และ Cooling อย่างต่อเนื่อง
ดังนั้นความสามารถในการ Maintenance Infrastructure โดยไม่หยุด Critical Compute จึงมีมูลค่าทางเศรษฐกิจสูง
AI Data Center จึงต้องให้ความสำคัญกับ Redundant Power, Redundant Cooling, Distribution Architecture และ Concurrent Maintenance อย่างมาก
แต่ไม่ได้หมายความว่า AI Data Center ทุกแห่งต้องได้รับ Tier III Certification เพราะ AI Workload แต่ละประเภทมี Resilience Requirement แตกต่างกัน และบางระบบสามารถจัดการ Failure ในระดับ Software หรือ Distributed Computing ได้
คำถามที่ถูกต้องจึงไม่ใช่ “AI Data Center ต้อง Tier อะไร?” แต่คือ “ความเสียหายทางธุรกิจจะเป็นเท่าไร หาก Infrastructure ต้องหยุดเพื่อ Maintenance หรือเกิด Failure?”
จากนั้นจึงออกแบบระดับ Resilience ให้เหมาะสม
Tier III ไม่ได้วัดว่า Data Center “เขียว” หรือไม่
อีกเรื่องที่ต้องแยกออกจากกันอย่างชัดเจนคือ Tier ≠ Sustainability
Tier III ไม่ได้หมายความว่า Data Center มี PUE ต่ำ ไม่ได้หมายความว่าใช้น้ำน้อย ไม่ได้หมายความว่าใช้ Renewable Energy มาก และไม่ได้หมายความว่าปล่อย Carbon ต่ำ
Data Center สามารถเป็น Tier III แต่ใช้พลังงานไม่มีประสิทธิภาพได้ ในทางกลับกัน Data Center ที่มี PUE ต่ำมากก็ไม่ได้หมายความว่าจะเป็น Tier III
เพราะตัวชี้วัดสองชุดตอบคำถามคนละเรื่อง
Tier ตอบคำถามว่า Infrastructure มี Resilience และ Maintainability อย่างไร?
ส่วน PUE, WUE และ Carbon ตอบคำถามเรื่อง Resource Efficiency และ Environmental Performance
Data Center ยุคใหม่จึงต้องคิดสองเรื่องพร้อมกัน Reliability + Sustainability
Tier III ในยุค Liquid Cooling จะซับซ้อนขึ้น
เมื่อ AI Rack Density เพิ่มขึ้น Data Center จำนวนมากเริ่มนำ Liquid Cooling มาใช้มากขึ้น
ระบบ Cooling จึงอาจไม่ได้จบเพียง Chiller และ CRAH แต่เพิ่ม Cooling Distribution Unit หรือ CDU, Manifold, Liquid Loop และ Heat Exchanger เข้าไปใกล้ Server มากขึ้น
ทุก Component ที่เพิ่มขึ้นสร้างคำถามใหม่ CDU Maintenance ได้หรือไม่? Pump ใน CDU มี Redundancy หรือไม่? Liquid Distribution Path สามารถ Isolate ได้หรือไม่? ถ้า Heat Exchanger ถูกนำออกจากระบบ Critical Rack ยังได้รับ Cooling หรือไม่?
ดังนั้นหลัก Concurrent Maintainability จะยิ่งสำคัญในยุค AI เพราะ Power Density สูงขึ้นทำให้เวลาที่ระบบสามารถอยู่ได้หลัง Cooling Failure อาจลดลง
Reliability ต้องมาพร้อม Energy Efficiency
อย่างไรก็ตาม Redundancy มีต้นทุน
ถ้าเราติดตั้ง Generator เพิ่ม UPS เพิ่ม Chiller เพิ่ม Pump เพิ่ม Transformer และ Distribution Path เพิ่มทั้งหมด Infrastructure Cost ก็เพิ่มขึ้น และถ้าออกแบบไม่ดี Auxiliary Energy Consumption ก็อาจเพิ่มขึ้นด้วย
นี่คือโจทย์ของ Data Center ยุคใหม่
เราต้องการ High Reliability แต่ในขณะเดียวกันก็ต้องการ Low PUE + Low WUE + Low Carbon
ดังนั้นวิศวกรต้องหาจุดสมดุลระหว่าง Reliability, Efficiency, CAPEX, OPEX และ Sustainability ไม่ใช่เพิ่ม Redundancy ไปเรื่อย ๆ โดยไม่วิเคราะห์ความจำเป็น
มุมมองเชิงยุทธศาสตร์ของประเทศไทย
ถ้าประเทศไทยต้องการก้าวไปสู่การเป็น ASEAN AI Hub, Cloud Region และ Hyperscale Data Center Hub เราจำเป็นต้องมอง Data Center มากกว่าเรื่องการจัดหาที่ดินและไฟฟ้า
Infrastructure ต้องรองรับทั้ง Grid Stability, Reliable Power Architecture, Renewable/Clean Energy, Water Management, Advanced Cooling, Digital Connectivity และ Skilled Workforce พร้อมกัน
Data Center ขนาดใหญ่ที่เข้ามาลงทุนในประเทศไทยจะมี Requirement ด้าน Availability และ Resilience สูงขึ้นตามความสำคัญของ Workload
Tier III และ Tier IV จึงเป็นกรอบอ้างอิงที่มีประโยชน์ในการทำความเข้าใจว่า Critical Infrastructure ควรถูกออกแบบอย่างไร
แต่ประเทศไทยไม่ควรใช้คำว่า Tier เป็นเพียงเครื่องมือทางการตลาด สิ่งสำคัญกว่าป้ายว่า “Tier III” คือ Infrastructure ที่สร้างขึ้นสามารถทำตาม Performance Objective ของระดับนั้นได้จริงหรือไม่
Tier III คือ “ซ่อมได้ โดยธุรกิจไม่ต้องหยุด”
หากต้องสรุป Tier III ให้เข้าใจง่ายที่สุด Tier I คือมี Infrastructure พื้นฐานสำหรับ Data Center Tier II เพิ่ม Redundant Capacity Components Tier III เพิ่มความสามารถในการ Concurrently Maintainable และ Tier IV เพิ่ม Fault Tolerance
ดังนั้นหัวใจของ Tier III ไม่ใช่จำนวน Generator ไม่ใช่จำนวน Chiller ไม่ใช่จำนวน UPS และไม่ใช่ตัวเลข Availability 99.982%
แต่คือคำถามง่าย ๆ ว่า “ถ้าผมต้องเอา Component หรือ Distribution Path นี้ออกจากระบบเพื่อ Maintenance ตามแผน IT จะยังทำงานต่อได้หรือไม่?”
ถ้าคำตอบคือ “ได้” สำหรับทุกส่วนที่มาตรฐานกำหนด Architecture นั้นจึงเข้าใกล้หัวใจของ Tier III
และนี่คือเหตุผลว่าทำไมคำว่า Concurrently Maintainable จึงเป็นหนึ่งในแนวคิดที่สำคัญที่สุดของการออกแบบ Data Center สมัยใหม่
เพราะในโลกยุค AI ที่ Compute มีมูลค่ามหาศาล Data Center ที่ดีไม่ใช่เพียง Data Center ที่ “ไม่เสีย” แต่ต้องเป็น Data Center ที่สามารถ ซ่อม เปลี่ยน และบำรุงรักษาได้ โดยธุรกิจดิจิทัลยังเดินหน้าต่อไป
